Ana sayfa → Teknik
Mikroservislerde Log ve Metrik: Altı Log Dosyası Değil, Tek Ekran
Pazartesi 09:12, alarm: “CPU %68.” Kimse bakmadı; her Pazartesi
çalıyordu. 09:40, destek: “Ödeme sayfası dönüyor.” Zincirdeki altı servis,
altı log akışı, altı ayrı sekme. Sorunu bulan şey grep oldu, 12:10’da —
başlangıçtan üç saat sonra.
Sebep ödeme servisinin latency’siydi ve 09:05’ten beri grafikte duruyordu —
kimsenin bakmadığı bir dashboard’da.
- Sorun araç eksikliği değildi. Metrik de vardı log da; ayrı yerlerde, ayrı zaman eksenlerinde, ayrı sekmelerdeydi.
- Metrik Prometheus’a, log Loki’ye, ikisi Grafana’da. Ayrı yoldan gidip aynı ekranda, aynı saniyede buluşurlar. Değer araçlarda değil, aynı zaman ekseninde.
- Metrik “ne kadar”, log “ne oldu”. Metrikte spike’ı gör, aynı saniyenin loguna in. Tersi çalışmıyor.
- Label ucuz değil. Metriğe kullanıcı kimliği koyan Prometheus’u öldürdü: 2,4 milyon seri. Disiplin yetmedi; bariyer koyduk.
- Alarm belirtiye değil, kullanıcının hissettiğine. CPU alarmı 11 gece uyandırdı, hiçbirinde kullanıcı bir şey hissetmedi.
Önce dur: neye bakıyorsun?
Monolitte tek bir log dosyası vardı ve tail -f yetiyordu. Servis sayısı
on ikiye çıkınca (o sabah altısı olayın zincirindeydi) aynı alışkanlık altı sekmeye, sonra bir hata için üç saatlik bir
yolculuğa dönüştü. Geçiş yazısında bunu
“görünmezlik” diye anlatmıştım; bu yazı o üç saati 25 dakikaya nasıl
indirdiğimizin hikâyesi.
Üç ayrı sinyal var ve üçü ayrı soruya cevap veriyor:
| Sinyal | Cevapladığı soru | Ne zaman bakılır | Bu yazıda |
|---|---|---|---|
| Metrik | Ne kadar? Ne zaman başladı? | Önce — spike’ı burada görürsün | Evet |
| Log | Tam olarak ne oldu? | Sonra — spike’ın saniyesine inince | Evet |
| Trace | Hangi servisin içinde, kaç ms? | Zincir uzunsa | Ayrı yazı; buradan köprüsü exemplar |
Sıra önemli ve bizim üç saatlik yolculuğumuzun sebebi tam da sırayı ters kurmaktı: loga bakarak spike aranmaz. Altı servisin logunda “bir gariplik” aramak samanlıkta iğne; metrikte önce “09:05’te ödeme p95 üç katına çıkmış” diyorsun, sonra o saniyenin logunu açıyorsun. Bir dakikalık iş.
Yapı: metrik Prometheus’a, log Loki’ye, ikisi Grafana’da
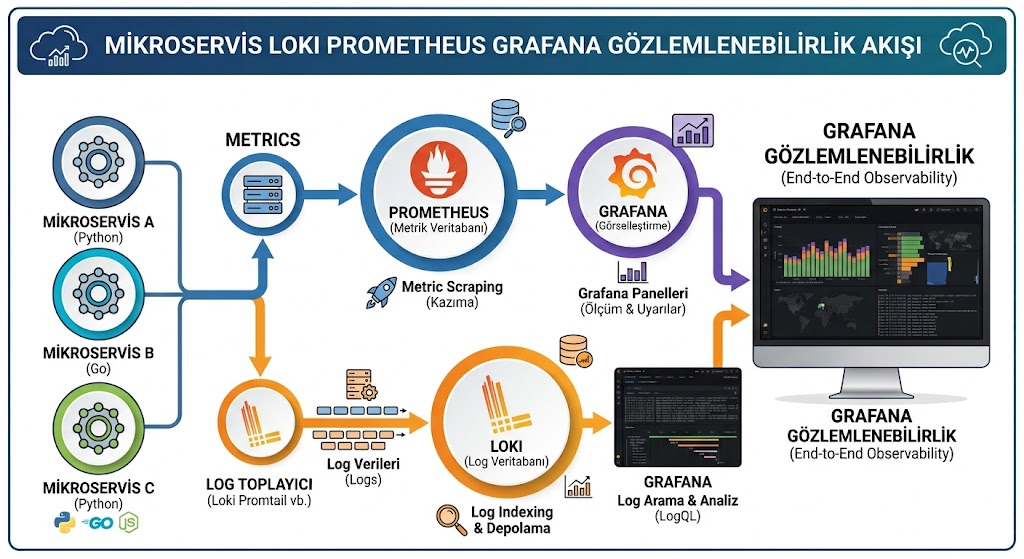
/metrics açar, Prometheus bizim ayarımızla 15 saniyede bir (varsayılan 1 dakika) gelip çeker. Log tarafı: servisler stdout’a yazar, bir ajan toplar (görselde Promtail; bugün Alloy, aşağıya bak), Loki saklar. Grafana ikisini aynı zaman ekseninde tek ekranda gösterir.# her servis bir uc acar; Prometheus 15 saniyede bir gelip okur
GET /metrics
# sayac: surec basladigindan beri biriken toplam (kumulatif;
# olay penceresindeki oran bu sayidan degil rate() ile okunur)
http_requests_total{service="odeme",route="/pay",status="200"} 48213
http_requests_total{service="odeme",route="/pay",status="500"} 512
# histogram: kumulatif kovalar + toplam + adet
http_request_duration_seconds_bucket{service="odeme",le="0.1"} 39880
http_request_duration_seconds_bucket{service="odeme",le="0.3"} 47102
http_request_duration_seconds_bucket{service="odeme",le="1"} 48180
http_request_duration_seconds_bucket{service="odeme",le="2.5"} 48590 # ust kovalar sart: en buyuk sonlu
http_request_duration_seconds_bucket{service="odeme",le="5"} 48700 # kova 1 sn olsaydi p95 hic 1,8 sn
http_request_duration_seconds_bucket{service="odeme",le="10"} 48722 # gosteremezdi (en fazla 1 sn derdi)
http_request_duration_seconds_bucket{service="odeme",le="+Inf"} 48725 # sart: quantile bunsuz calismaz
http_request_duration_seconds_sum{service="odeme"} 6417.2
http_request_duration_seconds_count{service="odeme"} 48725
Servis kendisi hiçbir yere göndermiyor; sayaçları bellekte tutuyor, Prometheus
gelip okuyor. Bu yüzden Prometheus düşse servis etkilenmiyor, servis düşse
Prometheus bunu up == 0 diye zaten görüyor — en ucuz sağlık
kontrolü. Yukarıdaki route label’ı şablonlanmış yol
(/orders/:id); ham yol (/orders/4711) olarak yazılırsa
kullanıcı kimliğinden farkı kalmaz — birazdan geleceğiz.
# servis stdout'a tek satir JSON yazar, baska hicbir sey yapmaz
{"ts":"2026-09-07T09:05:14.310+03:00","level":"error","service":"odeme",
 "correlation_id":"c-7f3a","event_id":"E2","msg":"psp timeout","duration_ms":3012}

# ajan konteynerin stdout'unu okur, Loki'ye gonderir
# Loki yalnizca LABEL'LARI indeksler: service, level, env
# satirin icerigi indekslenmez -> ucuz, ama arama label'la baslamaliPromtail 2 Mart 2026’dan beri end-of-life: destek bitti, güncelleme gelmeyecek. Geliştirme Grafana Alloy’da sürüyor — OTLP uyumlu tek ajan; log, metrik ve trace’i aynı süreç toplar, mevcut Prometheus ve Loki backend’leriyle olduğu gibi çalışır. Mevcut kurulumu taşımak tek komut:
alloy convert --source-format=promtail --output=config.alloy promtail.yamlYazının geri kalanında “ajan” dediğim yer, bizde Promtail’dı; bugün Alloy. Mimari değişmiyor, ajan değişiyor.
Loki’nin ucuz olmasının sebebi “yalnızca label’ları indeksler” satırı:
Elasticsearch her kelimeyi indekslerken Loki birkaç label’ı indeksliyor, satırın
kendisini sıkıştırıp saklıyor. Günde 40 GB log için Elasticsearch kümesi üç sunucuydu;
Loki tek sunucu ve nesne depolama. Bedeli de aynı yerde: aramaya label’la
başlamak zorundasın ({service="odeme"}), sonra içeriği süzersin.
“Bütün loglarda 4711 geçen satırlar” sorgusu Loki’de pahalı; “ödeme
servisinin son 10 dakikasında 4711” ucuz.
Metrik: dört altın sinyal, gerisi gürültü
İlk dashboard’umuzda 41 grafik vardı: CPU, bellek, GC süresi, thread sayısı, disk, ağ, JVM havuzları. Kimse bakmıyordu, çünkü hiçbiri “kullanıcı şu an ne yaşıyor” sorusuna cevap vermiyordu. İkinci dashboard’da her servis için dört grafik kaldı. PromQL’leri olduğu gibi kopyalanabilir; ikisinin ilk hâlini yanlış yazmıştık, aşağıda neden.
| Sinyal | PromQL | Ne söyler |
|---|---|---|
| Trafik | sum(rate(http_requests_total{service="odeme"}[5m])) | İstek düştüyse önündeki bir şey bozuk |
| Hata | sum(rate(http_requests_total{service="odeme",status=~"5.."}[5m])) | Oran; sayı değil |
| Latency | histogram_quantile(0.95, | p95; ortalama değil |
| Saturation | connection pool, kuyruk uzunluğu, consumer lag | Dolmaya ne kadar kaldı |
# hata orani - BOZUK: status label'i iki tarafta da var,
# Prometheus label'lari eslestirir, 500 yalnizca 500 ile bolunur -> hep 1
rate(http_requests_total{status=~"5.."}[5m]) / rate(http_requests_total[5m])

# p95 - EKSIK: sum by (le) yoksa her pod icin ayri p95 cikar;
# servisin p95'i degil N tane pod p95'i alirsin, alarm da pod basina calar
histogram_quantile(0.95, rate(http_request_duration_seconds_bucket[5m]))
Servis kırılımı istiyorsan sum by (service, le). İki sorguyu da tek
pod’lu test ortamında yazmıştık; orada ikisi de “çalışıyordu”.
Üç tuzak daha, üçünü de yaşadık:
Kargo servisinin ortalama latency’si 120 ms’ydi ve dashboard yeşildi. p95 ise 1,4 saniye: her yirmi müşteriden biri en az 1,4 saniye bekliyordu ve bunu ortalama görmüyordu. Latency grafiği her zaman percentile çizer. Bir de fan-out var: bir kullanıcı isteği zincirde altı servisten geçiyorsa her servisin p95’i ayrı ayrı yeşil olsa bile uçtan uca “yirmide bir” değil, altı kez yirmide bir; servis başına p95 kullanıcının gördüğünü olduğundan iyi gösterir.
Percentile’ın da sınırı var: histogram_quantile kova sınırları arasında
doğrusal interpolasyon yapar, yani p95’in doğruluğu kova seçimine bağlı
(le="1" ile le="2.5" arasında 1,8 diyorsa bu bir tahmindir; en büyük sonlu kova 1 olsaydı 1,8’i hiç göremezdin).
Ve percentile’lar toplanamaz: iki servisin p95’inin ortalaması
anlamlı bir sayı değildir; ham kovalar toplanır, quantile en son alınır. Native
histogram’lar (Prometheus 2.40+) kova kardinalitesini ve interpolasyon hatasını
büyük ölçüde çözüyor; yeni kurulumda ilk tercih o.
# bir gelistirici "hangi musteri yavas" diye sunu ekledi:
http_request_duration_seconds{service="odeme", user_id="184203", ...}

# her farkli user_id = ayri zaman serisi
# 2,4 milyon seri -> Prometheus OOM -> butun metrikler 40 dakika kor
Label, sayılabilir küçük bir küme için var: servis adı, şablonlanmış route, status code, ortam. Kullanıcı, sipariş, istek kimliği, ham URL — hiçbiri label değil. “Hangi müşteri yavaş” sorusu metriğin değil logun sorusu; correlation kimliğiyle loga inince zaten cevaplanıyor.
O gün öğrendiğimiz asıl şey: “geliştirici eklemesin” bir bariyer değildir. Bir daha olmaması için Prometheus’a sınır koyduk:
# prometheus.yml - scrape job'inda
sample_limit: 20000      # hedef bundan fazla seri dondururse scrape reddedilir
label_limit: 30          # bir metrikte en fazla 30 label
target_limit: 500

metric_relabel_configs:  # tehlikeli label'lari daha girmeden dusur
  - regex: "user_id|order_id|request_id"
    action: labeldrop

# haftada bir bak: en kalabalik label'lar ve metrikler
curl -s localhost:9090/api/v1/status/tsdb | jq .data.seriesCountByMetricName
Loki tarafında karşılığı tenant başına stream limitleri
(max_streams_per_user, per_stream_rate_limit). Sınır aşılınca
o servis reddedilir, dashboard kör kalmaz. Sınırı aşan servis kırmızı bir alarm alır; 40
dakika körlüğe kıyasla iyi bir anlaşma.
Log: satır değil, yapı
Monolitten miras kalan log satırları şöyleydi:
2026-09-07 09:05:14 ERROR PaymentClient - timeout after 3012ms for order 4711 (retry 2)Okunabilir, ama sorgulanamaz: “3 saniyeden uzun süren ödeme çağrıları” sorusu için düzenli ifade yazıyorsun, ertesi hafta biri mesajı değiştirince ifade sessizce boş dönüyor.
{"ts":"2026-09-07T09:05:14.310+03:00","level":"error","service":"odeme",
 "correlation_id":"c-7f3a","event_id":"E2","order_id":4711,
 "msg":"psp timeout","duration_ms":3012,"retry":2}

# LogQL: label'la basla, satir filtresiyle kirp, sonra alanla suz
{service="odeme"} |= "psp timeout" | json | duration_ms > 3000
{service=~"odeme|kargo"} |= "c-7f3a" | json | correlation_id = "c-7f3a"
Ortadaki |= asıl performans kaldıracı: sıkıştırılmış satırlarda çalışır
ve | json’a giden veriyi büyük ölçüde kırpar. | json her
satırı parse eder; satır filtresi olmadan gerçekten yavaştır. İkinci sorgu bütün
hikâye: bir müşterinin isteğinin altı servisteki izi tek sorguyla, zaman sırasında.
Her satırda zorunlu dört alan var ve servis iskeleti bunları otomatik koyuyor:
service, level, correlation_id,
event_id. Geliştirici yalnızca msg ve kendi alanlarını
yazıyor. Bu dördü olmayan bir satır, olmayan bir satırdır. event_id, satırı yazdıran
domain olayının kimliği (SiparisOlustu = E1 gibi; geçiş
yazısındaki üç kimlikten biri): “bu satır hangi olay işlenirken yazıldı” sorusu
tek sorguda cevaplanıyor.
Aynı hatayı log tarafında da yaptık: correlation_id’yi Loki
label’ı yaptık, “hızlı arayalım” diye. Her istek ayrı bir stream
yarattı, Loki indeksi şişti, sorgular dakikalar sürdü. Kural aynı: label
sayılabilir küme, kimlikler satırın içinde.
Loki 3.x’te bunun için bir orta yol var: structured metadata.
correlation_id gibi yüksek kardinaliteli alanlar stream label’ı
olmadan, ama | json maliyeti de ödenmeden saklanıp süzülebiliyor
({service="odeme"} | correlation_id = "c-7f3a"). “Kimlikler satırın
içinde” kuralının bugünkü hâli bu; ajan Alloy ise OTLP üzerinden kendiliğinden
dolduruyor.
“Hata satırında bağlamın tamamı” kuralı ödeme servisinde tehlikeli: ödeme
çağrısının girdisini olduğu gibi loglamak kart numarası, ad, adres loglamak demek
— KVKK ve PCI DSS açısından bir olay, hem de log saklama süresi boyunca. Kural
şöyle: girdi maskelenerek (4111********1111), kişisel
alanlar hiç yazılmadan; maskeleyi geliştirici değil log kütüphanesi yapar. Bu maddeyi
bir denetimde değil, bir sızıntı tatbikatında öğrendik.
Aynı ekran, aynı zaman ekseni
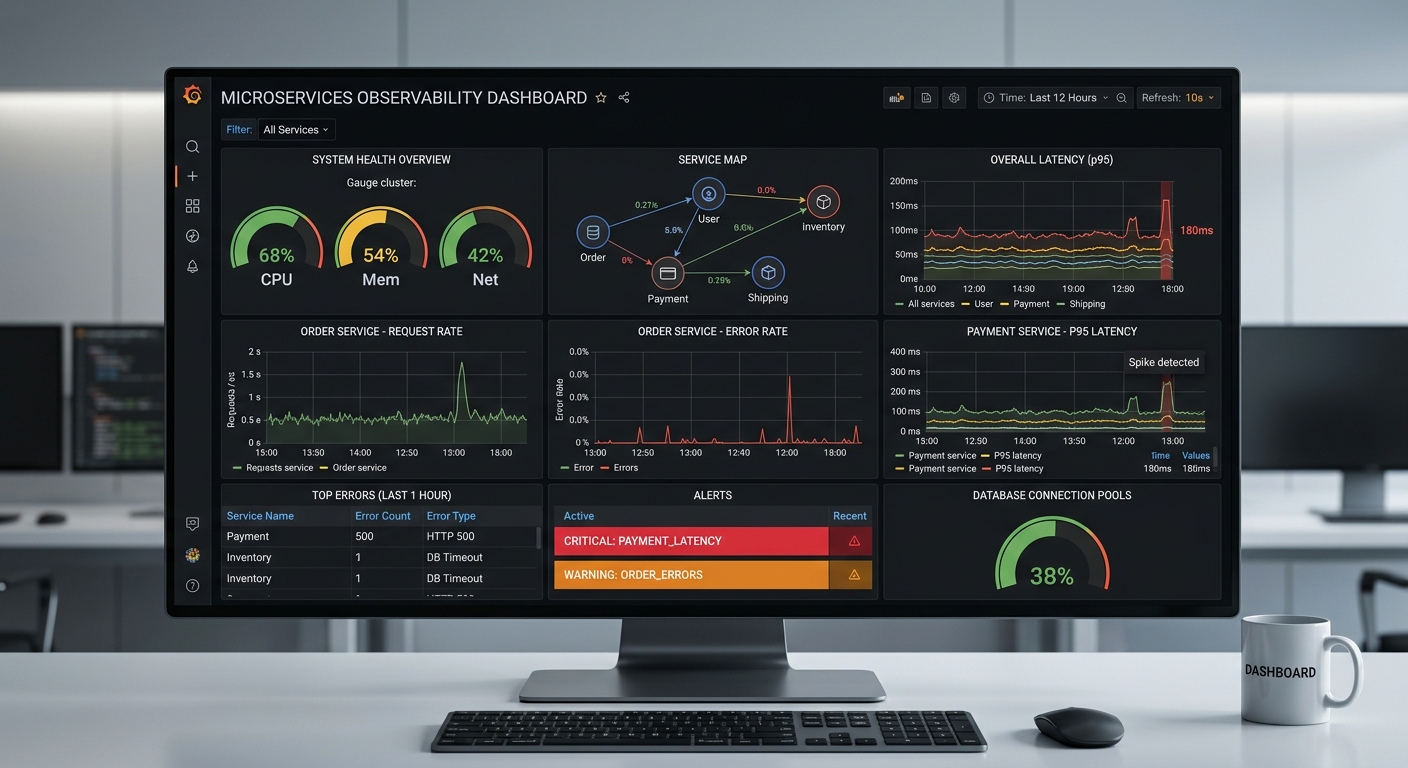
Dashboard’un düzeni bir okuma sırası: üstte kullanıcının hissettiği (latency, hata), ortada sebep adayları (request rate, connection pool, consumer lag), altta kanıt (son hatalar, aktif alarmlar). Nöbetçi sabah dashboard’u açtığında gözü yukarıdan aşağı iniyor ve üçüncü satıra geldiğinde çoğu zaman sebep belli.
Asıl numara grafiklerde değil, zaman ekseninin ortak olmasında. Latency grafiğinde 09:05’i seçiyorsun; log paneli aynı aralığa gidiyor; service map’te o dakikada kimin kime hata döndüğü kırmızı. Üç ayrı araçta bunu elle yapmak — saati kopyala, sekme değiştir, yapıştır, saat dilimi farkını düzelt — üç saatin yarısıydı.
- Sağ üst: p95 80 ms’den 1,8 sn’ye. Başlangıç 09:05:10.
- Altındaki panel: error rate %0,1’den %4’e, aynı saniye. Yani yavaşlamakla kalmıyor, düşüyor.
- Service map: odeme → psp kenarı kırmızı. Sorun bizde değil, ödeme sağlayıcıda.
- Grafiğe tıkla → Loki:
{service="odeme"} |= "psp timeout" | json | duration_ms > 3000— olay penceresinde 117 satır. - Karar: devre kesiciyi aç, müşteriye “şu an alamıyoruz” göster, sağlayıcıyı ara. Süre: 6 dakika.
Metrikten trace’e giden köprü de aynı
ekranda: exemplar. Histogram kovası yazılırken o örneğe ait
trace_id de saklanıyor; latency grafiğindeki bir noktaya tıklayınca
Grafana seni doğrudan o isteğin trace’ine götürüyor. “p95 neden 1,8 sn”
sorusunun cevabı bir tık uzakta: hangi servisin içinde, hangi çağrıda. Alloy
OTLP ile geldiğinde bunun doğal hali OpenTelemetry: log satırına trace_id ve
span_id kendiliğinden giriyor, correlation_id onların yerini alıyor ve
log → trace geçişi de tek tık oluyor.
Bir de dashboard’un kendisi: JSON’u ve alarm kuralları git’te, provisioning ile yükleniyor. Elle düzenlenen dashboard bir hafta sonra kimsenin ne olduğunu bilmediği bir şeye dönüşüyor; git’teki dashboard’un kim, ne zaman, neden değiştirdiği belli.
Alarm: belirtiye değil, kullanıcının hissettiğine
Baştaki sabaha dönelim. 09:12’de çalan CPU alarmı doğruydu — CPU gerçekten %68’di — ve tamamen işe yaramazdı. Kullanıcı CPU hissetmez; latency ve hata hisseder. Üstelik o alarm her Pazartesi sabahı trafik artınca çalıyordu; ekip onu okumamayı çoktan öğrenmişti. Sürekli çalan alarm, sessize alınmış alarmla aynıdır.
| Sebep alarmı (eski) | Belirti alarmı (yeni) | |
|---|---|---|
| Ne ölçer | CPU, bellek, disk, GC | p95 latency, error rate, consumer lag, servis ayakta mı |
| Ne zaman çalar | Eşik aşılınca, anında | Belirti eşiğinin 5 dakika boyunca üstünde kalınca |
| Ayda gece alarmı | 11 | 4 |
| Alarmların kaçı gerçek sorun | 2 / 11 | 4 / 4 |
| CPU nerede | alarm | dashboard’da grafik; sebep ararken bakılır |
# belirti esigi: p95, servis genelinde (sum by le), 5 dakika surerse
- alert: OdemeGecikmesi
  expr: histogram_quantile(0.95,
          sum by (le) (rate(http_request_duration_seconds_bucket{service="odeme"}[5m]))) > 0.3
  for: 5m
  labels:  { severity: critical }
  annotations:
    summary: "odeme p95 5 dakikadir 300 ms ustunde"
    runbook: "https://wiki/runbook/odeme-gecikme"   # ilk uc adim burada

# rate() uzerine kurulu alarm trafik sifirlaninca BOS doner ve susar.
# Servis tamamen duserse bunlar calar:
- alert: OdemeAyaktaDegil
  expr: up{job="odeme"} == 0
  for: 2m
- alert: OdemeMetrikYok
  expr: absent(rate(http_requests_total{service="odeme"}[5m]))
  for: 5m
- alert: OdemeTrafikDustu
  expr: sum(rate(http_requests_total{service="odeme"}[5m]))
        < 0.3 * sum(rate(http_requests_total{service="odeme"}[5m] offset 1w))
  for: 10m

# olu adam anahtari: HEP calar. Alertmanager'da "bu alarm susarsa haber ver"
# kurali var; susarsa Prometheus ya da alarm zincirinin kendisi olmus demektir.
- alert: Watchdog
  expr: vector(1)
  labels: { severity: none }
for: 5m alarmın yarısını tek başına eledi: tek spike’a çalan alarm
gürültü, beş dakika süren spike olay. Alttaki üç kural olmadan “servis öldü”
en sessiz olaydır — p95 alarmı hesaplayacak veri bulamaz ve hiçbir şey demez. Watchdog
da aynı sınıfın cevabı: 40 dakika kör kaldığımız olayda bize haber veren hiçbir
şey yoktu; şimdi hep çalan bir alarm var ve sustuğu an dış bir kanal arıyor.
runbook satırı da küçük görünür; gece üçte uyanan kişinin ilk üç adımı
hatırlamak zorunda kalmaması demek.
Bir dürüstlük notu: tablodaki “belirti eşiği” bir SLO alarmı değil; daha iyi seçilmiş bir eşik. Gerçek SLO alarmı hata bütçesinin yanma hızına (burn rate) kurulur: “son 1 saatte bütçe 14 kat hızlı yanıyorsa ve son 5 dakikada da öyleyse çal” gibi çoklu pencere, çoklu hız. Sabit eşik gece 3’te 3 dakikalık bir spike’a susmayı bilir ama bütün gün süren yüzde 1’lik bir bozulmayı hiç görmez; burn rate ikisini de doğru sınıflar. Biz oraya altıncı ayda geçtik; bu yazının sayıları belirti eşiği dönemine ait.
11’den 4’e inişin yarısı kurallardan, yarısı alarmın kişiye nasıl ulaştığından geldi. Alertmanager’da dört şey:
- Gruplama: altı servisin aynı dakikada çalan hata alarmları tek bildirim; on iki ayrı telefon çağrısı değil.
- Inhibition:
up == 0çalıyorsa aynı servisin p95 ve hata alarmları susturulur — sebep belli, belirtiyi ayrıca söylemeye gerek yok. - Susturma (silence): planlı bakımda alarm bir saatliğine, gerekçesiyle susturulur; “bakımda, boş ver” mesajıyla değil.
- Watchdog: hep çalan alarm bir dış servise gider; 5 dakika gelmezse o servis telefonu çaldırır — alarm zincirinin kendisinin alarmı.
- Nöbet rotasyonu: critical nöbetçiye telefon, warning sabah kanalına. Gece üçte warning gelmez.
Kimsenin hesaplamadığı bedeller: hacim, saklama, tek nokta
Structured log güzel; her şeyi loglamak değil. Üçüncü ayda günlük log hacmi
40 GB’a çıktı ve yarısı tek bir servisin debug
seviyesinde her isteği iki kez yazmasıydı. Üç kural koyduk:
- Üretimde
infove üstü.debugyalnızca bir olay sırasında, tek servis için, bir saatliğine açılır — ve kapatan bir zamanlayıcı var. - Mutlu yol tek satır. Bir isteğin başarıyla bitmesi bir satır; adım adım anlatım yok. Adımlar metrik.
- Hata satırı tam (maskeli), başarı satırı kısa. Hata satırında bağlam: girdi maskelenmiş, süre, deneme sayısı; başarıda yalnızca kimlikler ve süre.
Hacim 40 GB’tan 9 GB’a indi ve arama hızlandı; Loki’de sorgu süresi taranan veriyle doğru orantılı.
Hacmin doğal devamı saklama. Prometheus’un yerel saklaması varsayılan
15 gün; “geçen çeyrekte ne oldu” sorusu için remote_write ile
Mimir ya da Thanos’a yazmak gerekiyor — biz Mimir’e 13 ay tutuyoruz.
Loki tarafında asıl fatura kalemi nesne depolama; retention_period ve
compactor ayarı olmadan 9 GB/gün bile bir yılda 3 TB’a çıkıyor. Bizde 30 gün
sıcak, 1 yıl ucuz katman, sonra silme.
Ve tek nokta: OOM ile 40 dakika kör kaldığımız Prometheus tek kopyaydı. Şimdi aynı hedefleri çeken iki paralel Prometheus var, ikisi de Mimir’e yazıyor; Grafana Mimir’den okuyor. Biri düşünce veri de dashboard da kaybolmuyor. Bu bir paragraf, ama 40 dakika körlüğün bir daha yaşanmamasının sebebi.
Sahadan: 3 saatten 25 dakikaya
| Önce (6 sekme + grep) | Sonra (tek ekran) | |
|---|---|---|
| Sorunlu servisi bulma | 40–90 dk | 2–5 dk |
| Kök sebebe ulaşma (ortalama) | 3 saat | 25 dk |
| Bir müşterinin isteğini uçtan uca görme | elle saat eşleştirme | tek LogQL sorgusu |
| Gece alarmı / ay | 11 | 4 |
| Gerçek sorun / alarm | 2 / 11 | 4 / 4 |
| Günlük log hacmi | 40 GB | 9 GB |
| Metrik dashboard’unun kör kaldığı süre | 40 dk (kardinalite) | 0 (limit + 2 kopya) |
| Metrik saklama | 15 gün | 13 ay (Mimir) |
| Dashboard’a bakan kişi sayısı | nöbetçi, o da bazen | her sabah ayakta toplantıda ekip |
Son satır en az teknik olanı ve en çok işe yarayanı. Dashboard, ayakta toplantının ilk dakikasında ekranda: dün gece ne oldu, hangi servis sınırda. Dashboard herkesin baktığı bir şey olunca grafikler de bakılan şeye göre evrildi; kimsenin bakmadığı 41 grafiklik dashboard hiç evrilmemişti.
Kontrol listesi
/metricsucu var mı, Prometheus hedef listesinde mi? Histogram+Inf,_sum,_countüretiyor mu?- Dört sinyal dashboard’da mı: trafik, error rate, p95 latency, saturation?
- Error rate
sum()ile, p95sum by (le)ile mi hesaplanıyor? (Tek pod’lu ortamda ikisi de yanlışken doğru görünür.) - Latency grafiği percentile mı, ortalama mı? En büyük sonlu kova, görmek istediğin en kötü değerin üstünde mi?
routelabel’ı şablonlanmış mı (/orders/:id)? Label’larda kimlik var mı?sample_limit,label_limitvemetric_relabel_configstanımlı mı? Loki stream limitleri var mı?- Loglar tek satır JSON mu?
service,level,correlation_id,event_idher satırda mı? - Loki label’ları yalnızca servis, seviye, ortam mı? Kimlikler satırın içinde ya da structured metadata’da mı?
- LogQL sorguları
|=satır filtresiyle kırpıyor mu, doğrudan| json’a mı gidiyor? - Girdi maskeleniyor mu? Kişisel/kart verisi loga hiç girmiyor mu?
- Üretimde log level
infomu?debug’ı kapatan zamanlayıcı var mı? - Alarmlar belirti üstünde mi (p95, error rate), sebep üstünde mi (CPU)?
up == 0,absent(), trafik düşüşü ve Watchdog kuralları var mı?- Her alarmda
forsüresi ve runbook bağlantısı var mı? Alertmanager’da gruplama ve inhibition kurulu mu? - Metrikten loga tek tıkla geçiliyor mu — aynı zaman aralığıyla? Exemplar açık mı?
- Saklama kararı verildi mi: Prometheus
remote_write, Lokiretention_period? - Prometheus tek kopya mı?
- Log ajanı Alloy mu, hâlâ Promtail mı?
- Dashboard ve alarm kuralları git’te mi, elle mi düzenleniyor?
- Dashboard’u son bir haftada nöbetçi dışında biri açtı mı?
Sonuç
Gözlemlenebilirlik araç satın almak değil; metriğin nereye bakacağını, logun ne gördüğünü söylediği ve ikisinin aynı saniyede yan yana durduğu bir düzen kurmak. Prometheus, Loki ve Grafana bunu ucuz yapıyor; ama aynı üçlüyle 41 grafiklik, kimsenin bakmadığı bir dashboard da kurabilirsin — biz kurduk. Yanlış PromQL’le yeşil gösteren bir dashboard da kurabilirsin — onu da kurduk.
Akılda kalacak sıra şu: önce dört sinyal, doğru PromQL’le; sonra structured log; sonra ikisini aynı zaman eksenine koy; alarmı kullanıcının hissettiğine bağla, servis ölürse de çalsın; label’ı kimlik için kullanma ve buna bariyer koy. Gerisi — service map, güzel göstergeler, renkli paneller — bu düzen kurulduktan sonra kendiliğinden geliyor, kurulmadan hiçbir işe yaramıyor.